A Fondo
NVIDIA y Microsoft dibujan el futuro del PC: IA local, agentes y RTX Spark

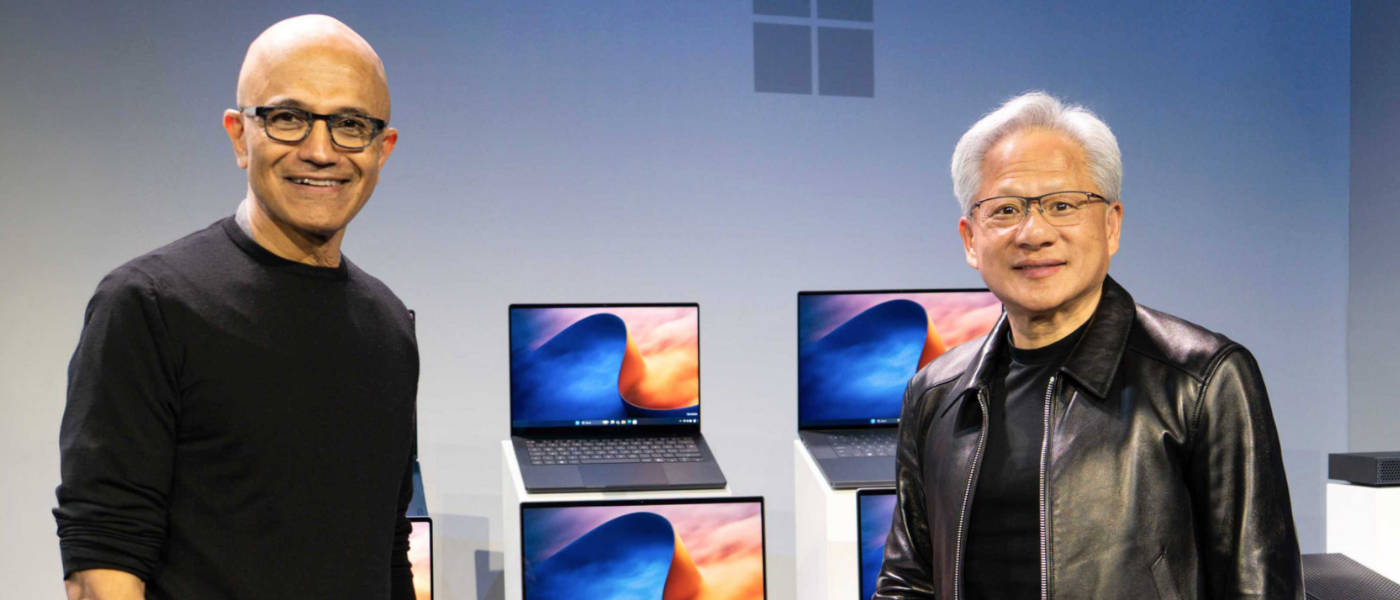
NVIDIA y Microsoft llevan meses preparando el terreno para una nueva generación de ordenadores capaces de ejecutar inteligencia artificial cada vez más avanzada directamente en local. RTX Spark ya nos había mostrado buena parte del hardware necesario para conseguirlo, pero el anuncio de hoy marca un cambio importante: los primeros portátiles ya se pueden reservar, llegarán al mercado el 16 de octubre y Windows empieza a enseñar cómo quiere aprovechar realmente esa capacidad de cálculo.
La propuesta va bastante más allá de añadir otra plataforma de hardware al catálogo. Microsoft ha detallado su estrategia de Hybrid Intelligence, que combina modelos ejecutados en el propio PC con servicios en la nube según las necesidades de cada tarea, y empieza a preparar Windows para una nueva generación de agentes capaces de acceder a contexto local, utilizar herramientas y continuar trabajando mientras el usuario hace otras cosas. Al mismo tiempo, Microsoft Execution Containers busca establecer los límites necesarios para que esos agentes puedan actuar sobre el sistema sin disponer de acceso indiscriminado a todo lo que contiene.
El resultado empieza a dibujar una idea del PC bastante distinta de la que hemos manejado hasta ahora alrededor de la inteligencia artificial. Los primeros equipos RTX Spark pueden alcanzar 128 GB de memoria unificada y un petaflop de cálculo para IA, mientras que NVIDIA y Microsoft extienden la misma filosofía hacia estaciones de desarrollo y, en el extremo superior, DGX Station para Windows. Más que presentar una pieza concreta de hardware, el evento de hoy empieza a unir productos, modelos locales, nube, agentes y seguridad dentro de una misma arquitectura.
RTX Spark ya tiene fecha, equipos y precios
La primera gran novedad es que RTX Spark entra por fin en fase comercial. Los primeros portátiles ya se pueden reservar y comenzarán a llegar al mercado el 16 de octubre, con modelos de ASUS, Dell, HP, Lenovo, MSI y Microsoft. Más adelante se sumarán otros fabricantes, mientras que los equipos compactos basados en la misma plataforma están previstos para noviembre. La propuesta cubre desde portátiles orientados a creación y desarrollo hasta estaciones de trabajo de pequeño formato, dejando claro que NVIDIA quiere extender RTX Spark mucho más allá de un único tipo de dispositivo.
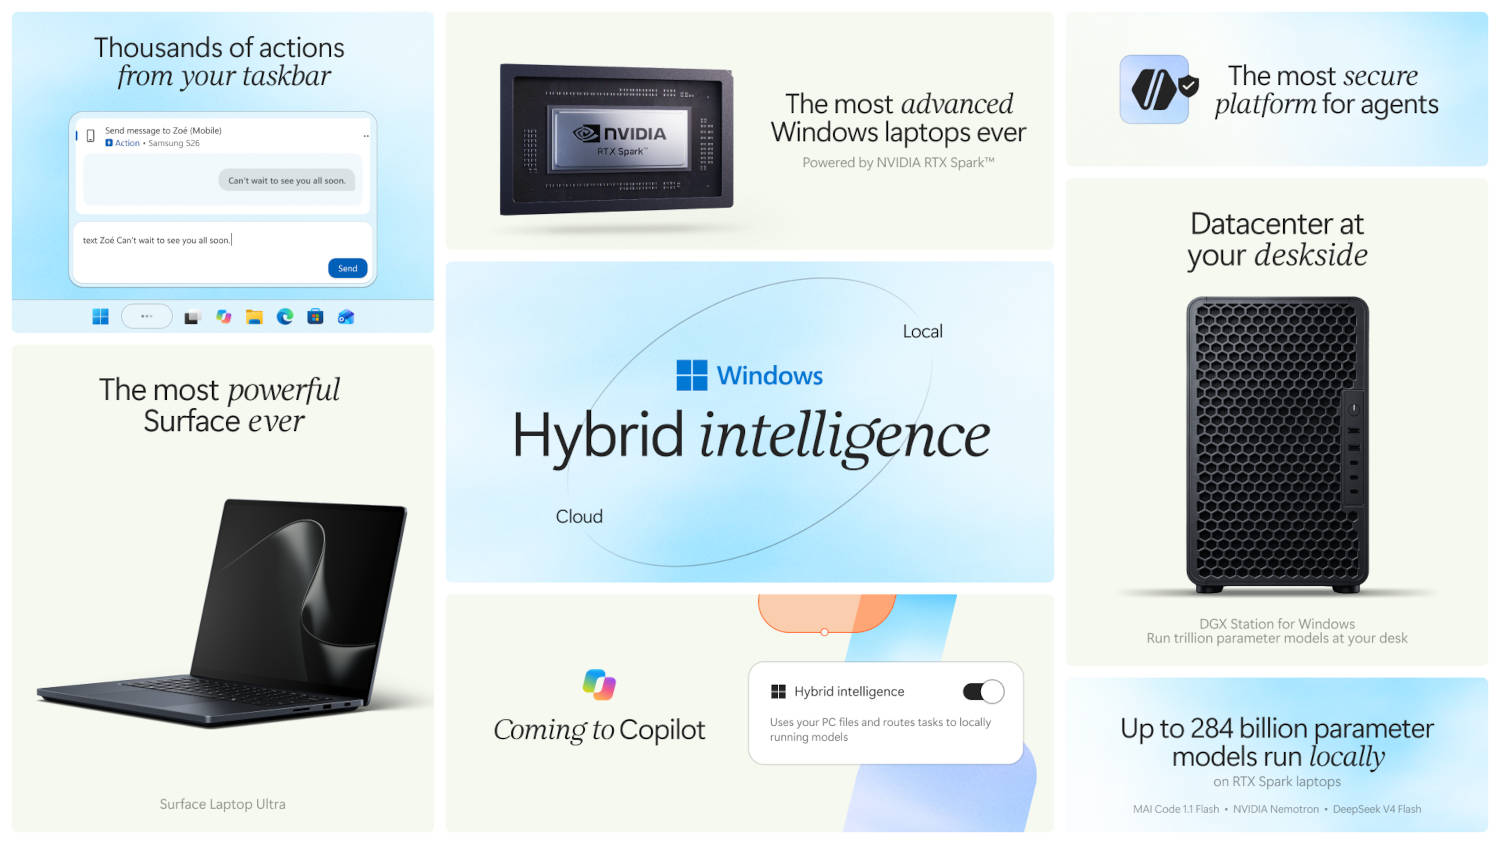
Surface Laptop Ultra sirve como una buena referencia para entender dónde se sitúa esta primera generación. Microsoft lo ofrece desde 2.599,99 dólares con 24 GB de memoria unificada y una configuración de RTX Spark con CPU de 18 núcleos y GPU de 5.120 núcleos, mientras que las versiones superiores alcanzan 128 GB de memoria, CPU de 20 núcleos y GPU de 6.144 núcleos. La propia Microsoft destaca además que estos equipos pueden ejecutar localmente modelos de más de 120.000 millones de parámetros y alcanzar hasta un petaflop de rendimiento para IA, dos cifras que ayudan a entender mejor el tipo de cargas que NVIDIA y Microsoft quieren llevar al PC.
La gama se completará en noviembre con Surface RTX Spark Dev Box, una estación compacta dirigida a desarrolladores, ingenieros de IA y equipos técnicos que parte de 5.999 dólares en Estados Unidos. Mantiene los 128 GB de memoria unificada y hasta un petaflop de capacidad para IA, pero cambia claramente el enfoque: no busca sustituir a un portátil convencional, sino ofrecer un entorno local preparado para inferencia, evaluación y experimentación con modelos y agentes. Con esta primera oleada ya queda bastante claro que RTX Spark nace como una plataforma premium y profesional, al menos de momento, y no como el reemplazo inmediato del PC medio.
¿Qué quiere hacer Microsoft con esa potencia local?
La llegada de equipos capaces de ejecutar modelos cada vez mayores en local obliga también a replantear cómo utiliza Windows esa capacidad. Microsoft denomina Hybrid Intelligence a una arquitectura en la que el sistema puede combinar modelos alojados en el propio PC con servicios en la nube, recurriendo a uno u otro entorno en función de las necesidades de cada tarea. La idea no pasa por sustituir el cloud, sino por aprovechar mejor ambos mundos: mantener determinadas operaciones cerca de los datos, reducir latencias y consumo de servicios externos cuando sea posible, y conservar al mismo tiempo el acceso a modelos de mayor escala cuando realmente sean necesarios.
Ese planteamiento empieza a cobrar sentido cuando se observan los modelos que Microsoft quiere ejecutar localmente sobre RTX Spark. MAI Code 1.1 Flash, presentado originalmente con 137.000 millones de parámetros totales y 6.800 millones activos, podrá funcionar en el dispositivo mediante cuantización a 3 bits, reduciendo su tamaño cerca de un 80% y manteniendo una ventana de contexto de 256K. También aparecen un próximo modelo Nemotron de NVIDIA con más de 70.000 millones de parámetros y algo más de 20 GB tras cuantizarlo a 2 bits, además de DeepSeek V4 Flash, con 284.000 millones de parámetros. El objetivo ya no es ejecutar pequeñas funciones de IA aisladas, sino llevar capacidades que hasta hace poco asociábamos exclusivamente a grandes servicios remotos hasta el propio PC.
Para conseguirlo, Windows necesita algo más que hardware potente. Microsoft está incorporando llama.cpp a Windows ML, lo que facilitará el acceso a modelos abiertos y permitirá aprovechar CPU, GPU o NPU mediante un mismo entorno de ejecución. Al mismo tiempo, GitHub ampliará HydraFusion, su sistema para seleccionar el modelo más adecuado para cada tarea, de manera que pueda recurrir también a modelos instalados localmente y no solo a servicios en la nube. Esta capacidad llegará en vista previa experimental durante octubre a GitHub Copilot, Copilot CLI y Visual Studio Code.
La consecuencia es un cambio importante respecto al concepto inicial del AI PC. La cuestión deja de ser únicamente cuántos TOPS ofrece una NPU o qué pequeñas funciones puede acelerar sin conexión: Windows empieza a prepararse para decidir dónde debe ejecutarse cada carga de inteligencia artificial. Para Microsoft, la IA local puede ayudar a controlar costes, mantener datos sensibles dentro del equipo y mejorar la respuesta de determinadas tareas, mientras que la nube seguirá aportando escala cuando haga falta. RTX Spark encaja precisamente en ese punto intermedio, ofreciendo suficiente memoria y capacidad de cálculo para que esa decisión entre local y cloud tenga cada vez más opciones reales.
Windows empieza a prepararse para agentes que actúan sobre el PC
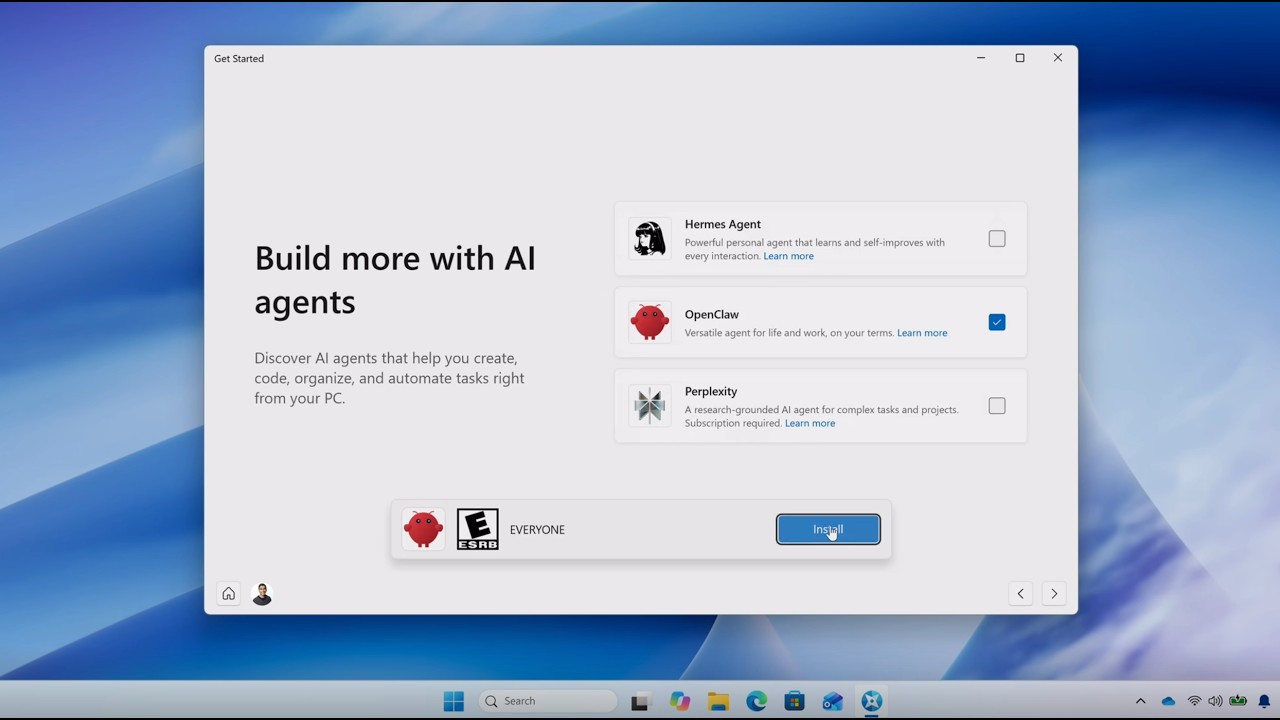
La siguiente pieza de esta estrategia son los agentes de IA capaces de trabajar directamente sobre el ordenador. Microsoft plantea una evolución de Copilot en la que el asistente no se limite a responder preguntas, sino que pueda utilizar contexto local, acceder a determinados recursos y ejecutar acciones en nombre del usuario. Esto incluye desde organizar archivos o ayudar con tareas de programación hasta mantener procesos activos en segundo plano mientras seguimos utilizando el equipo para otras cosas. La diferencia es importante: la IA deja de ser una aplicación aislada y empieza a integrarse de forma mucho más profunda en el propio funcionamiento de Windows.
Microsoft agrupa esta evolución alrededor de tres capacidades: contexto local, acciones locales y modelos locales. La primera permite que el agente entienda mejor la información disponible en el PC; la segunda le da capacidad para actuar sobre archivos, aplicaciones o herramientas; y la tercera permite utilizar modelos instalados directamente en el dispositivo cuando resulte más conveniente. A esto se suma Autopilot, que Microsoft presenta como un agente persistente y proactivo capaz de continuar trabajando de forma autónoma durante periodos prolongados, una idea que encaja especialmente bien con equipos como RTX Spark, diseñados para mantener cargas de IA complejas en ejecución local.
El mismo enfoque se extiende al desarrollo de software. GitHub está preparando HydraFusion para que pueda seleccionar de forma dinámica entre modelos locales y servicios cloud según la tarea, mientras que Copilot CLI y Visual Studio Code también formarán parte de esta integración. Esto permite imaginar flujos de trabajo en los que un agente pueda analizar código, consultar documentación, ejecutar pruebas o generar cambios utilizando recursos locales cuando sea suficiente y recurriendo a la nube cuando necesite más capacidad. La transición no consiste tanto en sustituir una herramienta por otra como en dar a los agentes acceso a distintos recursos y dejar que el sistema determine cuál utilizar en cada momento.
El salto, por tanto, no está únicamente en disponer de modelos más grandes dentro del PC, sino en permitir que esos modelos participen activamente en el trabajo diario. Y ahí aparece inmediatamente el siguiente problema: cuanto más puede hacer un agente dentro del sistema, más importante resulta controlar exactamente a qué puede acceder y qué acciones puede ejecutar. Esa necesidad explica buena parte del protagonismo que Microsoft está dando a Microsoft Execution Containers dentro de esta nueva arquitectura.
Microsoft Execution Containers: cómo poner límites a esos agentes
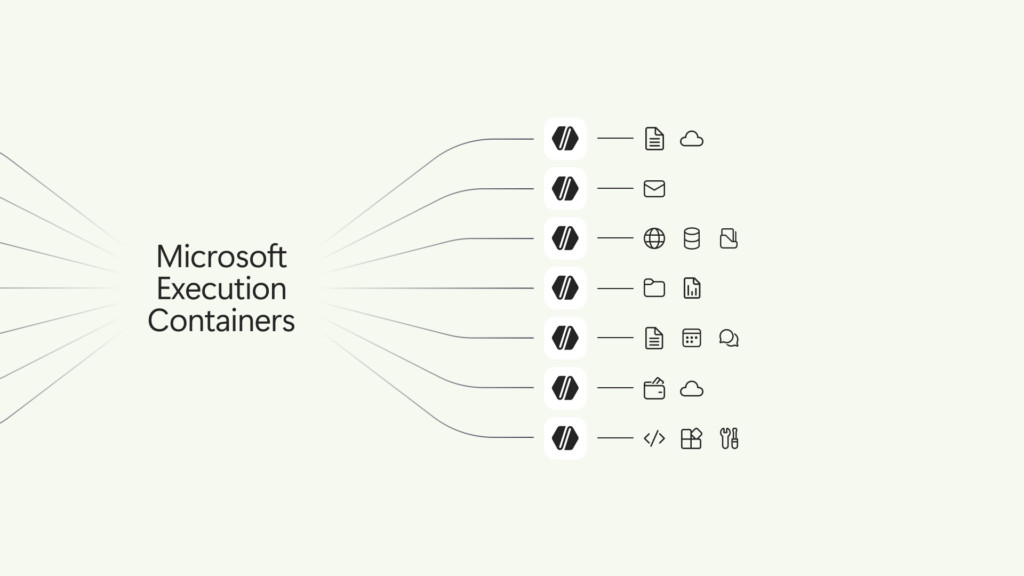
Permitir que un agente de IA actúe sobre el ordenador abre posibilidades muy interesantes, pero también introduce un problema evidente: para resultar útil necesita acceder a archivos, aplicaciones, redes y herramientas del sistema. Darle acceso indiscriminado a todos esos recursos sería difícilmente asumible, especialmente en entornos profesionales. Microsoft quiere responder a este reto con Microsoft Execution Containers, o MXC, una capa de aislamiento que ya está disponible de forma general en Windows 11 y que permite establecer de antemano qué recursos puede utilizar cada agente durante su ejecución.
MXC permite definir políticas concretas sobre acceso a archivos y conexiones de red, además de asignar una identidad específica a los agentes para distinguir sus acciones de las realizadas directamente por el usuario. La idea es que los límites no dependan únicamente de las instrucciones que recibe el propio modelo, sino que estén impuestos desde fuera por el sistema operativo, reduciendo así el riesgo de que una respuesta incorrecta, una instrucción mal interpretada o un intento de manipulación lleven al agente a realizar acciones para las que no debería tener permiso. En entornos empresariales, esta arquitectura puede complementarse además con herramientas de administración como Agent 365 e Intune.
NVIDIA añade otra capa mediante OpenShell, que permite aplicar políticas y mecanismos de aislamiento específicos para cada agente sobre esta infraestructura. La importancia de todo ello va más allá de una nueva función de seguridad: cuanto más capaces y autónomos sean los agentes, más necesario será separar claramente lo que pueden hacer de aquello que debe permanecer fuera de su alcance. Conseguir que una IA utilice un PC es solo una parte del problema; conseguir que pueda hacerlo sin convertir el acceso al sistema en un riesgo es probablemente una de las condiciones esenciales para que este modelo pueda extenderse de verdad.
De RTX Spark a DGX Station: NVIDIA y Microsoft amplían la escala
RTX Spark representa el punto de entrada de esta estrategia, pero NVIDIA y Microsoft quieren extenderla bastante más allá del portátil o el mini PC. En el extremo superior aparece DGX Station para Windows, una estación de trabajo basada en el superchip GB300 Grace Blackwell Ultra capaz de alcanzar hasta 748 GB de memoria coherente y 20 PFLOPS de rendimiento FP4. Su objetivo es permitir que empresas, desarrolladores y equipos de investigación trabajen localmente con modelos de hasta un billón de parámetros, ampliando considerablemente el tipo de cargas de IA que pueden mantenerse dentro de una infraestructura propia.
Microsoft plantea este tipo de sistemas alrededor de dos escenarios especialmente representativos. El primero es el concepto de Personal AI Supercomputer, pensado para ingeniería, ciencia, desarrollo y experimentación con modelos avanzados. El segundo es Windows Token Factory, una propuesta orientada a utilizar la estación como infraestructura local para alimentar múltiples agentes y cargas de inferencia dentro de una organización. La idea es que parte del trabajo que actualmente depende de servicios externos pueda ejecutarse sobre hardware propio, reduciendo la dependencia del consumo por tokens y manteniendo un mayor control sobre datos, modelos y recursos.
Windows ocupará además un papel central en esta propuesta, sin renunciar al ecosistema Linux que domina buena parte del desarrollo de inteligencia artificial. DGX Station podrá utilizar Windows como sistema principal mientras WSL mantiene el acceso a herramientas, librerías y entornos Linux, acercando así dos mundos que tradicionalmente han permanecido bastante separados. Es una pieza importante dentro de la visión conjunta de ambas compañías: que la misma arquitectura pueda escalar desde un portátil RTX Spark hasta una estación capaz de mover modelos de frontera sin abandonar el entorno Windows.
Todavía quedan muchas incógnitas alrededor de esta nueva generación de PC, desde su precio y adopción hasta la madurez real de los agentes y la evolución de Windows sobre ARM. Pero el anuncio de hoy permite ver por primera vez con bastante claridad cómo pretende encajar cada pieza. RTX Spark aporta la capacidad local, Windows conecta modelos y nube, los agentes convierten esa capacidad en acciones y MXC intenta poner límites a lo que pueden hacer. Más que un nuevo formato de ordenador, NVIDIA y Microsoft están intentando definir una plataforma en la que la inteligencia artificial deje de ser una función añadida y pase a formar parte permanente del propio sistema.







NVIDIA y Microsoft dibujan el futuro del PC: IA local, agentes y RTX Spark

SynthID abre su detector de contenido creado con IA

LibreOffice dice No a la IA como característica de la suite

GameStop cobra 1400 dólares por una PS5 Pro usada ¡Más cara que una nueva!

Consigue tu mini PC ACEMAGIC y NiPoGi con hasta un 20% de descuento

Qué placa base elegir: Guía de compras para Intel y AMD 2026

Qué procesador necesito para cada tarjeta gráfica: guía actualizada a 2026
Qué placa base elegir: Guía de compras para Intel y AMD 2026

NVIDIA DGX Spark de 64 GB: desarrollo e IA en local para todos

FLEXISPOT Balanso análisis completo

Samsung presenta sus nuevos tablets de gama alta, Galaxy Tab S12

GTA VI muestra su ambición en 12 nuevas imágenes
Qué placa base elegir: Guía de compras para Intel y AMD 2026
NVIDIA y Microsoft dibujan el futuro del PC: IA local, agentes y RTX Spark

Google presenta su nueva familia de modelos de IA, Gemini 4
FLEXISPOT Balanso análisis completo

AOC presenta su primer monitor de 1000 Hz

Cuáles son los tres conceptos más importantes de rendimiento en Internet y qué significan

-
 GuíasHace 5 días
Qué procesador necesito para cada tarjeta gráfica: guía actualizada a 2026
-
 GuíasHace 13 horas
Qué placa base elegir: Guía de compras para Intel y AMD 2026
-
 NoticiasHace 5 días
NVIDIA DGX Spark de 64 GB: desarrollo e IA en local para todos
-
 AnálisisHace 7 días
FLEXISPOT Balanso análisis completo