Noticias
El gran apagón de Outlook nació de un error que llevaba meses oculto

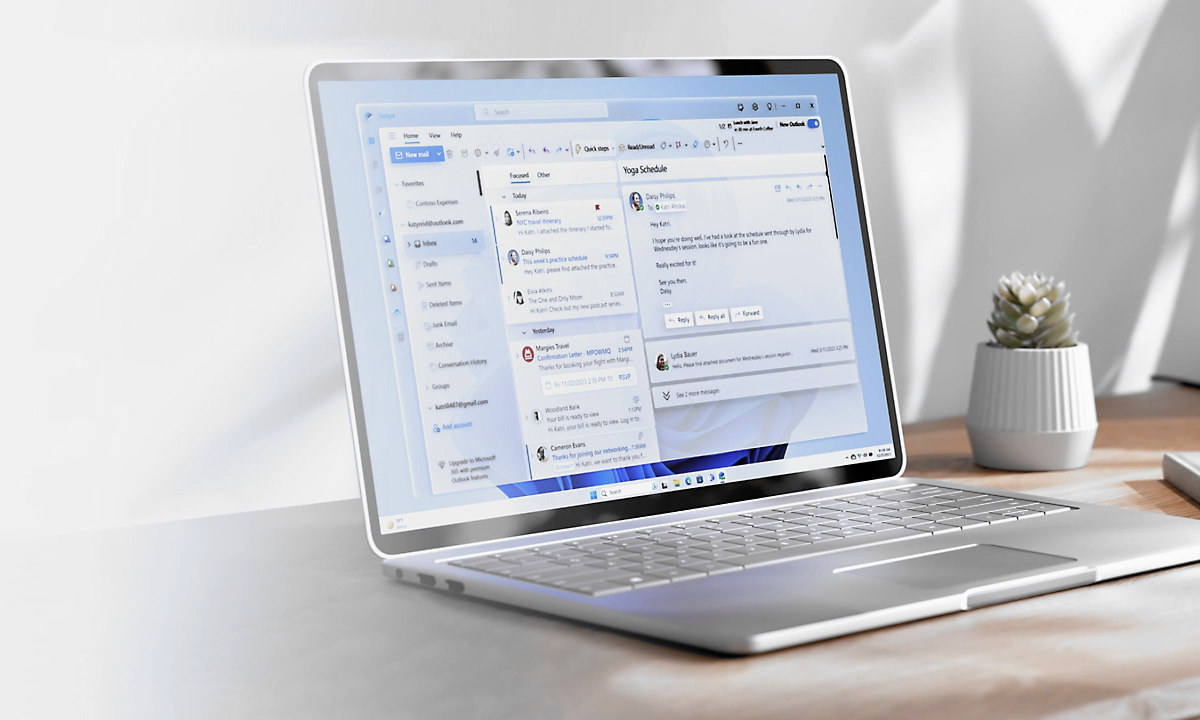
Cuando falla el correo de una empresa, la incidencia suele quedarse en sus oficinas. Cuando cae un servicio utilizado por millones de organizaciones, las consecuencias se extienden por medio mundo. Eso ocurrió con la caída de Outlook y Exchange Online del 12 de noviembre, que también afectó a funciones de Teams, Copilot y otros servicios de Microsoft 365. Ahora, un informe preliminar de Microsoft explica qué provocó las casi 24 horas de interrupción: un error de software introducido en julio que llevaba más de tres meses oculto en sus servidores de acceso. La compañía admite que sus pruebas no consiguieron detectarlo antes de desplegarlo.
El fallo permaneció latente hasta que coincidieron tres circunstancias. Unas quince horas antes de la caída, Teams trasladó automáticamente parte de su tráfico a la infraestructura compartida con Exchange Online, aumentando su carga. Al mismo tiempo, cerca del 14 % de la capacidad de esos servidores estaba temporalmente fuera de servicio. Ninguna situación debía provocar por sí sola un apagón, pero juntas activaron un defecto que agotaba la CPU y la memoria de los equipos. Las pruebas de Microsoft utilizaban máquinas menos potentes que las de producción, cuando el fallo empeoraba precisamente en servidores más modernos. A medida que algunos dejaban de responder, el tráfico pasaba a otros y extendía el problema: en menos de dos horas, más del 80 % de los servidores de esa infraestructura quedaron inoperativos.
La recuperación tampoco fue sencilla. Los equipos reiniciados volvían a saturarse al recibir las conexiones pendientes, y deshacer la actualización mediante los mecanismos habituales resultaba complicado porque llevaba meses desplegada. Microsoft tuvo que preparar una corrección y aplicarla progresivamente hasta restablecer el servicio el 13 de noviembre, a las 17:10 en España, tras 23 horas y 50 minutos. El informe reconoce también que fallaron los sistemas destinados a impedir que una avería se propagase entre regiones. La compañía ha reforzado la capacidad y los mecanismos de supervisión mientras prepara sus conclusiones definitivas. La caída demuestra que no basta con repartir la infraestructura: también hay que impedir que los sistemas de recuperación propaguen el fallo.







Malos tiempos para Firaxis: despidos masivos y un nuevo XCOM en dificultades

Gemini te deja guardar tus chats sin entrenar su IA… pero hay letra pequeña

Windows 11 lleva la cuenta de los agentes de IA que utilizas… sin avisarte

HP renueva su catálogo con OmniBook 5 y un ecosistema HyperX más completo

Diseño final de los Galaxy S27 Pro y Galaxy S27 Ultra y críticas de los fans: son «clones chinos baratos»

Microsoft lanza un parche de emergencia para corregir errores de activación de Windows

Diez errores frecuentes al montar un PC que debes evitar

Gemini 4 Carbon, la mejor IA de Google, cuesta 99,99 euros al mes

Las reservas de GTA VI baten récords y desde hoy puedes descargarlo

Este emulador te permite jugar a PS5 en PS4: sí, has leído bien

Razer Barracuda V2 Pro: grandes y muy grandes

El Galaxy S27 no copiará el diseño del iPhone 18 Pro, los Galaxy S27 Ultra y Pro sí
Malos tiempos para Firaxis: despidos masivos y un nuevo XCOM en dificultades

GIGABYTE presenta el AI TOP AERO, un compacto para IA local, creación de contenido y juegos
Las reservas de GTA VI baten récords y desde hoy puedes descargarlo
Gemini 4 Carbon, la mejor IA de Google, cuesta 99,99 euros al mes
Este emulador te permite jugar a PS5 en PS4: sí, has leído bien

La UE va a por las cajas de botín y las suscripciones trampa

-
 GuíasHace 5 días
Diez errores frecuentes al montar un PC que debes evitar
-
 NoticiasHace 6 días
Gemini 4 Carbon, la mejor IA de Google, cuesta 99,99 euros al mes
-
 NoticiasHace 6 días
Las reservas de GTA VI baten récords y desde hoy puedes descargarlo
-
 NoticiasHace 6 días
Este emulador te permite jugar a PS5 en PS4: sí, has leído bien