A Fondo
Zen 6 y Zen 6c de AMD a fondo: núcleos, configuración, rendimiento y comparativa frente a Zen 5 y Zen 5c

La semana pasada tuvimos la oportunidad de asistir a un evento especial que AMD celebró en Las Vegas, donde la compañía de Sunnyvale reveló todas las claves de Zen 6 y de su variante Zen 6c, dos arquitecturas que podemos definir casi como dos caras de la misma moneda, aunque con algunas diferencias importantes.
Ya sabéis cómo es esto. AMD no diferencia sus arquitecturas de la misma manera que Intel, así que la base de Zen 6 y de Zen 6c es la misma, pero dentro de esa base común hay diferencias que esta vez son más importantes que nunca, como os vamos a explicar en este artículo.
Antes de entrar en materia os recuerdo que todo lo que vamos a ver a continuación es oficial, lo que significa que no se trata de rumores, sino de información que nos ha proporcionado AMD. Si tenéis cualquier duda podéis dejarlas en los comentarios y os ayudaremos a resolverlas.
Claves de Zen 6 y Zen 6c a nivel de arquitectura
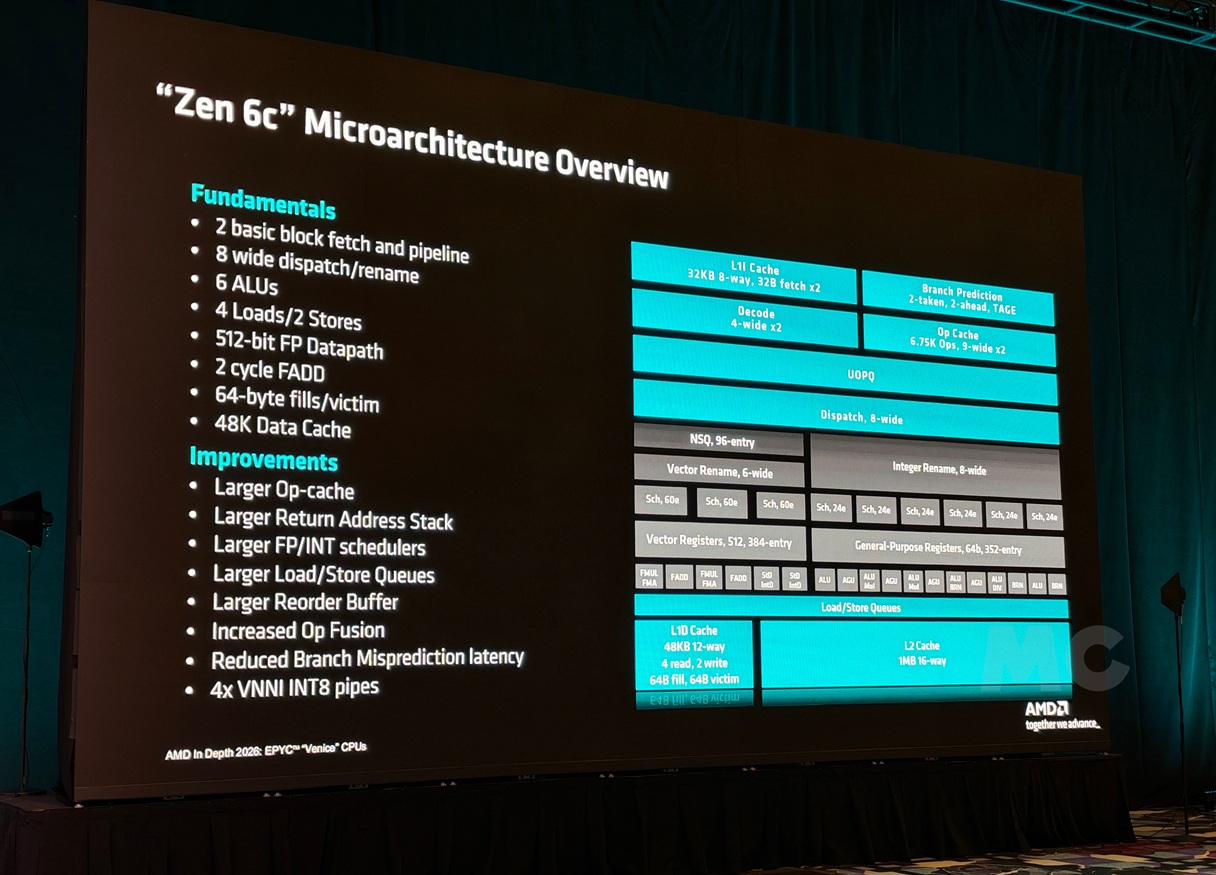
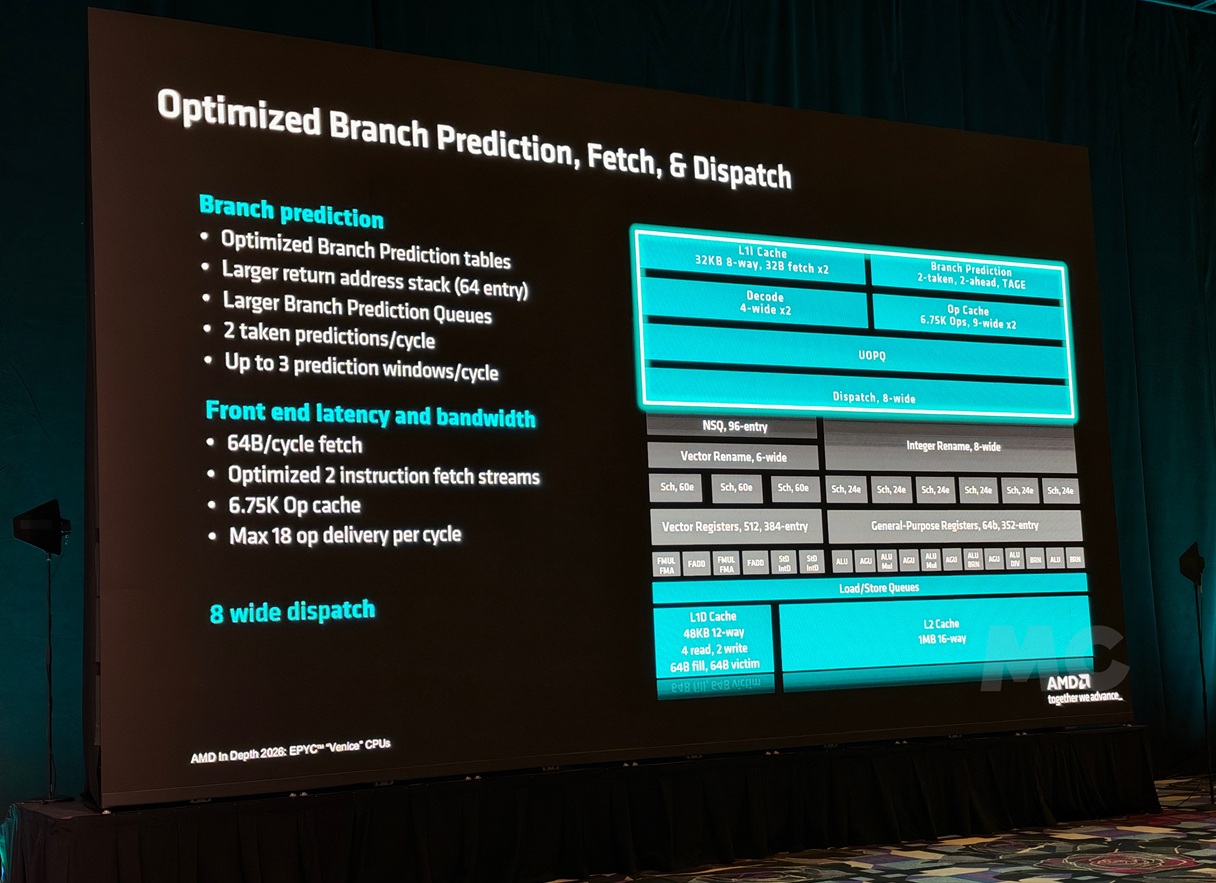
- Tablas de predicción de saltos optimizadas.
- Pila de retorno de direcciones más grande (64 entradas).
- Colas más grandes del predictor de saltos.
- Toma dos predicciones por ciclo y ventanas de hasta tres predicciones por ciclo de reloj.
- Ciclo de captación 64B.
- Captación optimizada con dos flujos de instrucciones.
- Caché OP 6,75 KB.
- Suministro de hasta 18 op (operaciones) por ciclo de reloj.
- Despacho de 8 vías (hasta 8 instrucciones por ciclo de reloj).
- Caché L1D de 48 KB y doce vías con carga de 4 ciclos.
- Segmentación (pipes) 4 LS que permite una mezcla de 4 cargas y 2 almacenamientos de instrucciones por ciclo.
- Llenado/»víctimas» de 64B desde/a caché L2.
- Búfer de traducción anticipada: L1 de 96 entradas totalmente asociativa con tamaño de página completo, y L2 con un tamaño de páginas de memoria de 4 KB «todo menos 1 GB», es decir, excluyendo páginas masivas de 1 GB.
- Aumento de las colas de trabajo: la de carga sube a 80 entradas, y la de almacenamiento sube a 128 entradas.
- Cola de ordenamiento de carga escalable.
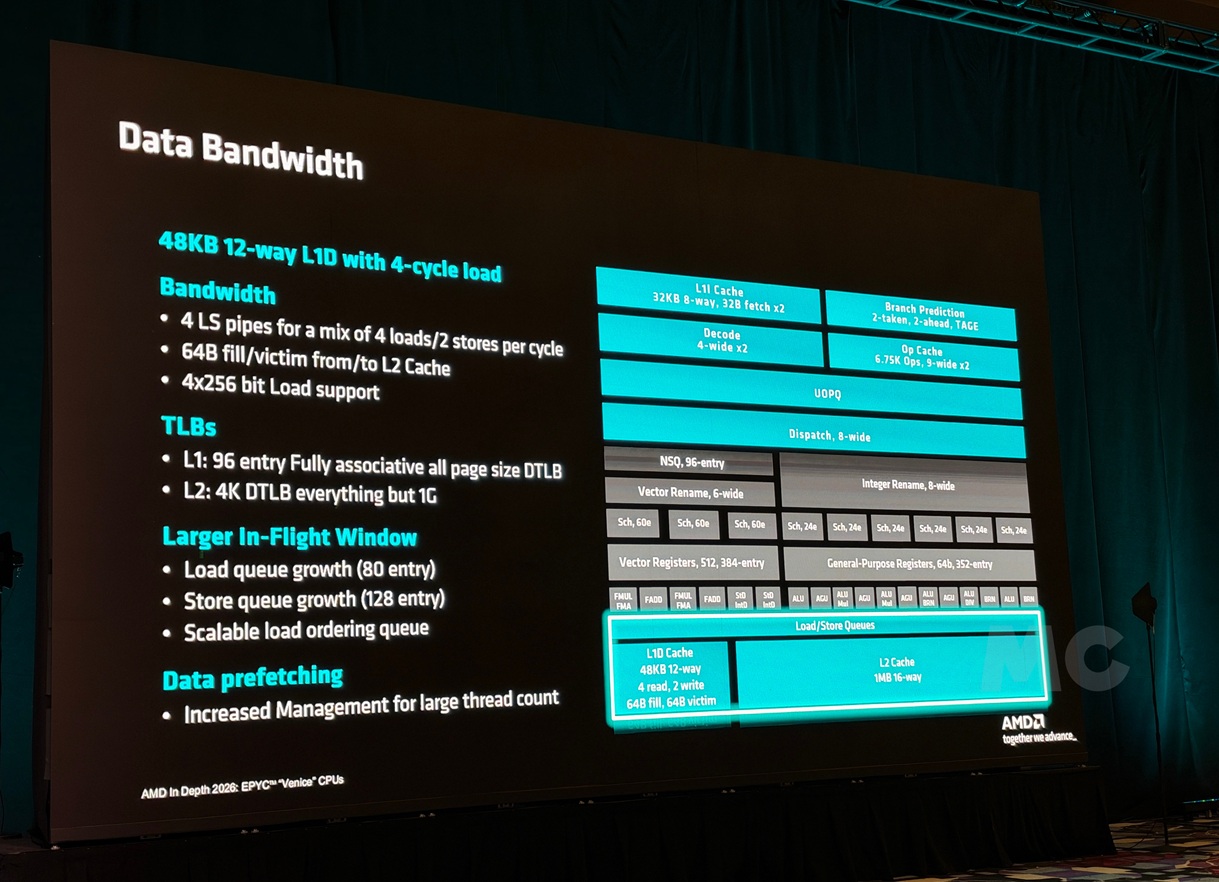
- Precarga de datos con gestión mejorada para trabajar con un mayor número de hilos.
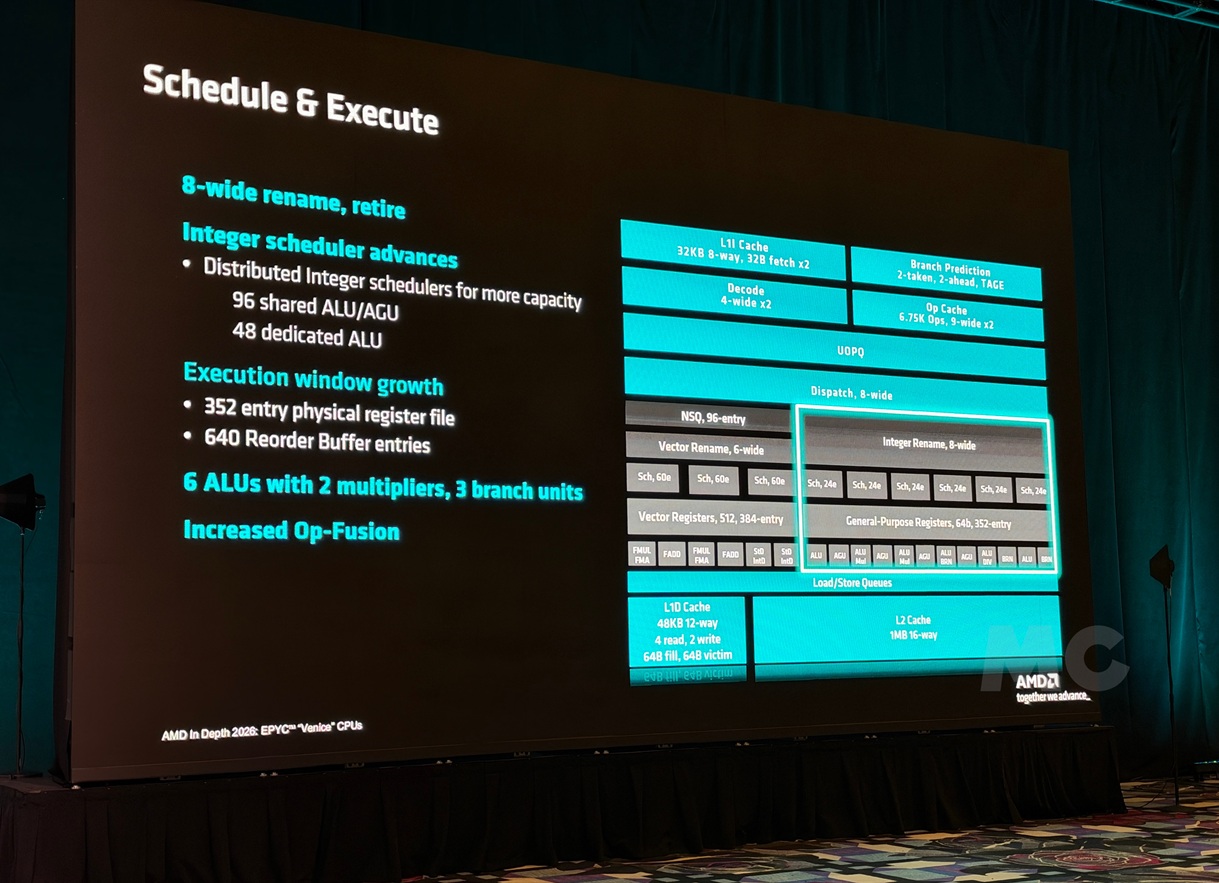
- Mejoras en la programación y ejecución: ancho de 8 instrucciones por ciclo para funciones de renombrar y retirar.
- Avances en programación de enteros: planificadores de enteros distribuidos de mayor capacidad.
- 96 ALUs/AGUs compartidas.
- 48 ALUs dedicadas.
- Archivo de registros físicos con 352 entradas.
- 640 entradas en el búfer de reordenamiento.
- 6 ALUs con dos unidades multiplicadoras y tres unidades de predicción de saltos.
- Fusión de operaciones aumentada.
- Vía de datos de 512 bits en la unidad de coma flotante (FP).
- Buffer de reordenación más grande.
- Reducción de latencia por predicción errónea en el predictor de saltos.
- Cuatro canales de datos VNNI INT8.
- Caché L2 de 1 MB por núcleo.
Nuevo set ISA (Arquitectura del Conjunto de Instrucciones)
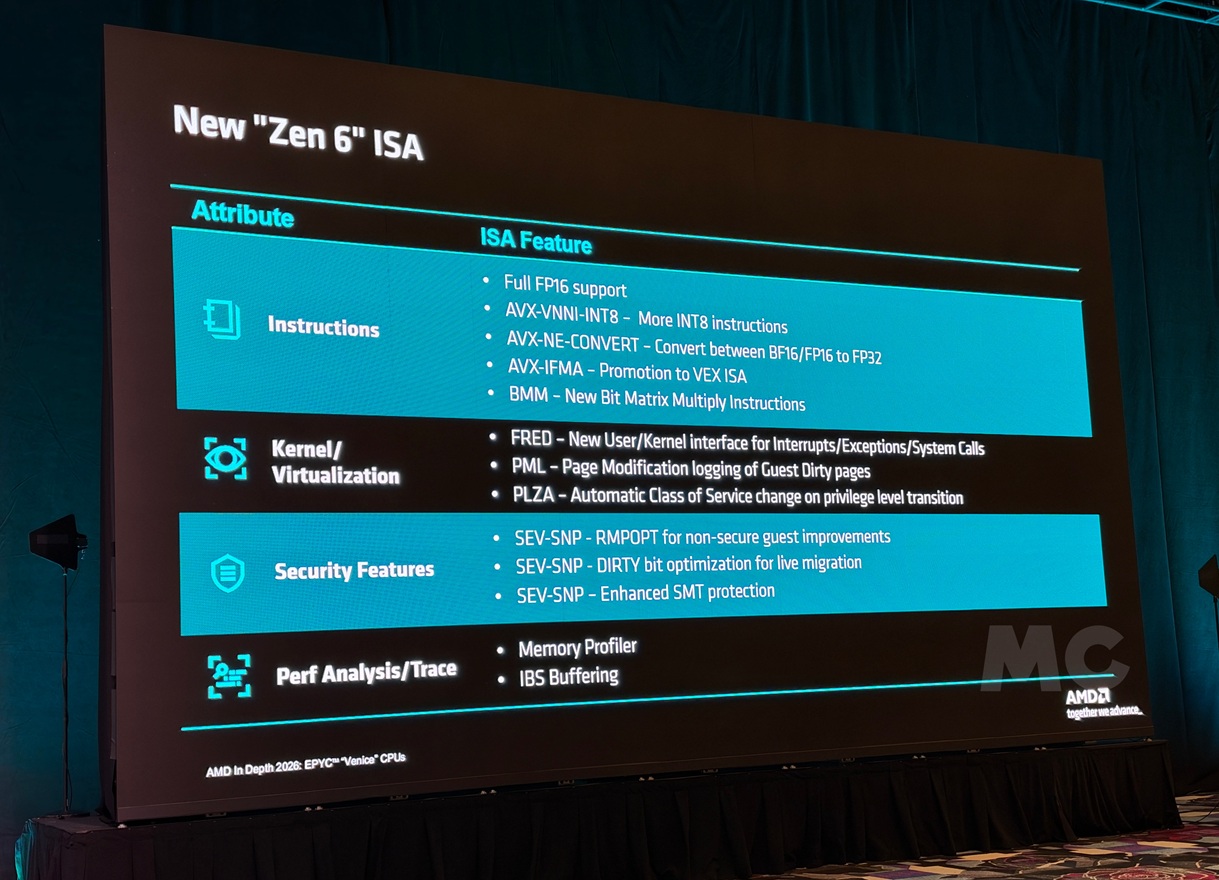
Instrucciones
- Soporte nativo completo de operaciones FP16 (precisión simple).
- AVX-VNNI-INT8 (más instrucciones INT8).
- AVX-NE-CONVERT: permite hacer conversiones de BF16 y FP16 a FP32.
- AVX-IFMA: facilita la promoción a VEX ISA.
- BMM: nuevas instrucciones de multiplicación de matrices de bits.
Kernel y virtualización
- FRED: nueva interfaz usuario/núcleo para interrupciones, excepciones y llamadas al sistema.
- PML: registro de modificaciones de páginas «sucias» (dirty pages) de invitados.
- PLZA: cambio automático de clase de servicio al realizar una transición de nivel de privilegios.
Funciones de seguridad
- SEV-SNP – RMPOPT: mejoras en áreas de invitados no seguras.
- SEV-SNP – DIRTY: optimización a nivel de bits para la migración en vivo.
- SEV-SNP: mejora de la protección al utilizar SMT (multihilo simultáneo, dos hilos por núcleo).
Análisis de rendimiento y seguimiento de seguridad
- Memory Profiler (analizador de memoria).
- IBS Buffering (almacenamiento en búfer del muestreo basado en instrucciones).
Zen 6 estrena nuevo chiplet, y nuevo nodo
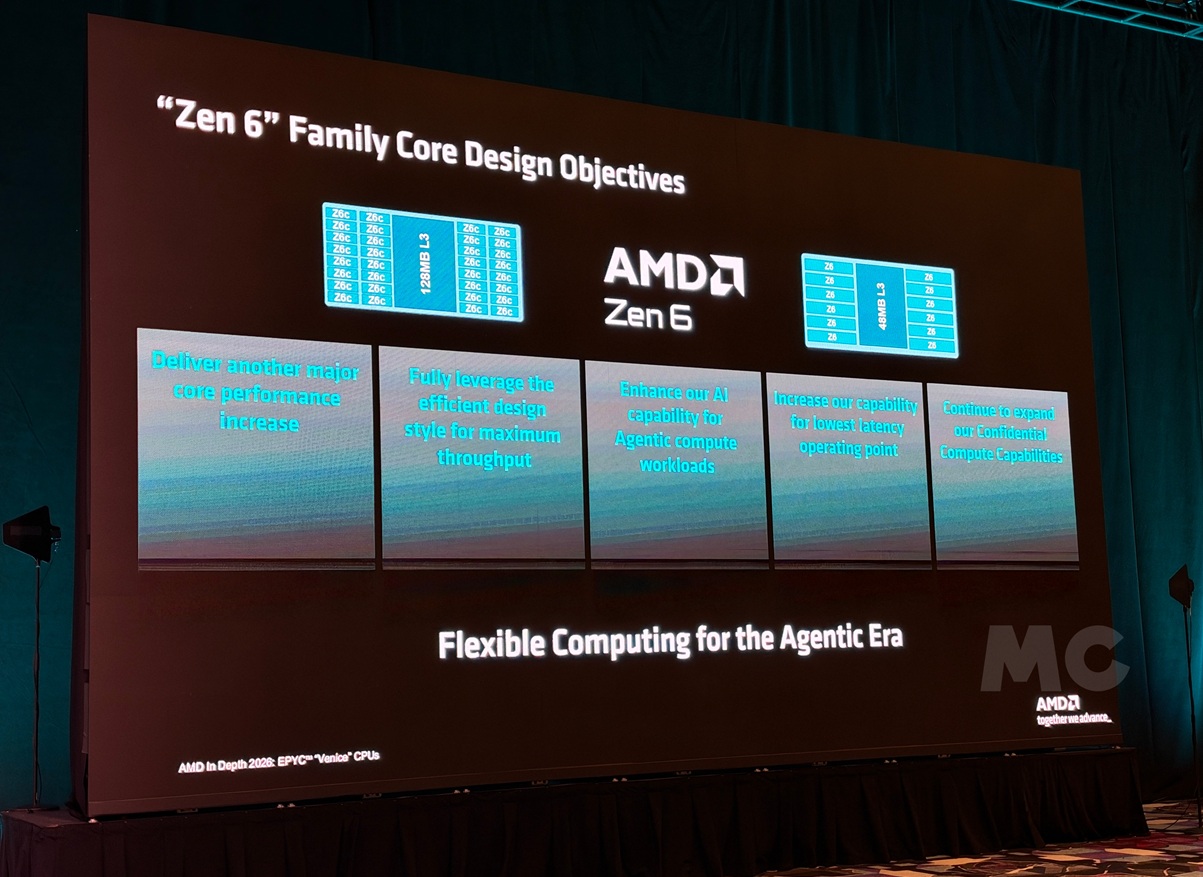
Tenemos varias mejoras importantes, pero sin duda la más relevante es que utiliza un chiplet CPU (también conocido como unidad CCD) que ha sido totalmente renovado, ya que este cuenta con un total de 12 núcleos que comparten 48 MB de memoria caché L3, lo que nos deja una relación de 4 MB por núcleo, aunque es importante destacar que cada núcleo puede acceder a toda la caché L3.
En Zen 5, tenemos un chiplet CPU que cuenta con 8 núcleos y 32 MB de caché L3. La relación de caché L3 por núcleo también es de 4 MB, y cada núcleo puede acceder al total de la caché de tercer nivel. La diferencia es, por tanto, de un aumento del 50% en la cantidad de núcleos e hilos, lo que nos garantía un aumento considerable de rendimiento multihilo, y un gran salto generacional en este sentido.
El chiplet CPU de Zen 6 está fabricado en el nodo de 2 nm de TSMC, un nodo que trae mejoras importantes a nivel de rendimiento por vatio, y que al reducir el tamaño de los transistores también reduce el área lógica y el tamaño del chip. Esto último tiene otra consecuencia importante, y es que mejora la eficiencia del diseño al trasladarlo a la oblea, ya que ocupa menos espacio a nivel de silicio comparado con nodos anteriores.
Zen 6 frente a Zen 5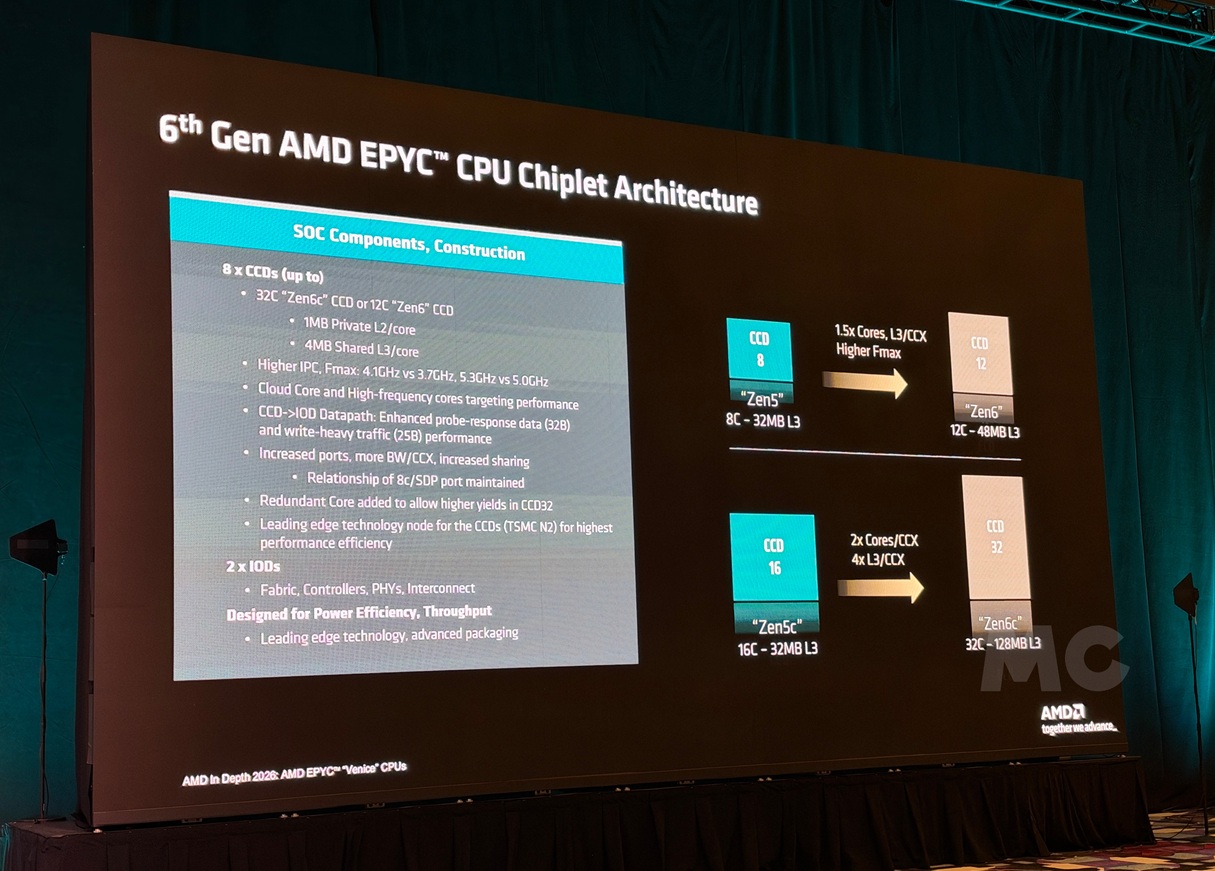
- Aumenta el máximo de núcleos por chiplet CPU de 8 a 12.
- Sube la frecuencia máxima de 5 GHz a 5,3 GHz (en CPUs EPYC).
- La caché L3 máxima sube de 32 MB a 48 MB.
- Máximo de núcleos por procesador: sube de 64 a 96.
- Máximo de hilos por procesador: sube de 128 a 192.
Esta arquitectura está optimizada para minimizar la latencia y maximizar el rendimiento por núcleo e hilo.
Zen 6c también estrena nuevo chiplet CPU y repite el nodo de 2 nm
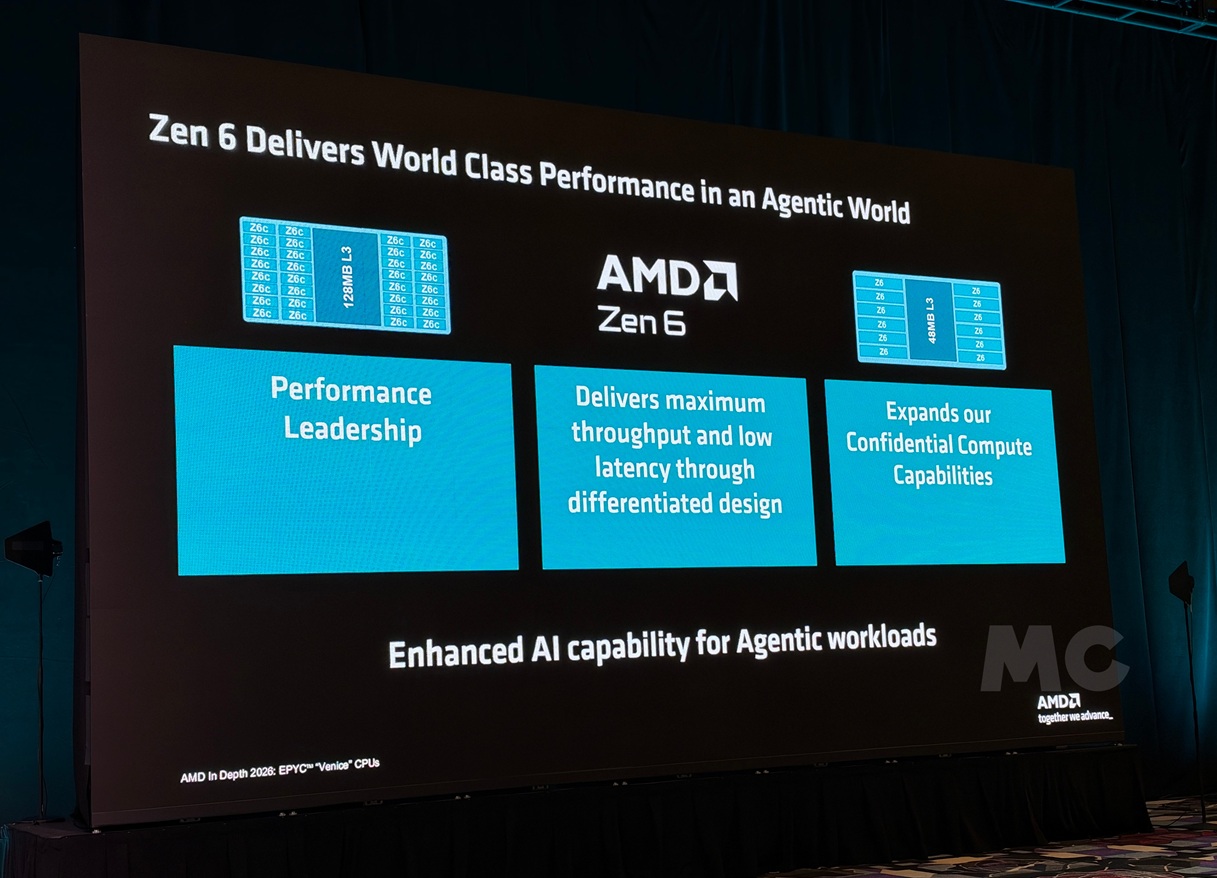
Un chiplet Zen 6 está configurado con 32 núcleos, puede trabajar con hasta 64 hilos y tiene un total de 128 MB de caché L3 compartida y accesible por todos los núcleos, lo que nos deja una relación de 4 MB de caché L3 por núcleo, el doble si comparamos con el diseño que tenía Zen 5c. La caché L2 se mantiene sin cambios, lo que significa que tenemos 1 MB por núcleo.
AMD ha logrado aumentar de forma drástica la densidad por núcleo, ya que ha doblado la cantidad de núcleos e hilos frente a la generación anterior, y también ha multiplicado por cuatro la cantidad total de caché L3 por chiplet CPU. En resumen, dos veces más núcleos e hilos, y cuatro veces más caché L3 sin recortes en la caché L2. Cambios muy grandes que confirman un gran salto generacional.
El nodo que utiliza el chiplet CPU es también el de 2 nm. Este nodo ha sido fundamental para conseguir las optimizaciones a nivel de rendimiento, de eficiencia y de reducción del tamaño de los transistores para poder aumentar tanto la cantidad de núcleos y la caché L3, manteniendo un área lógica optimizada que resulta viable económicamente una vez que se traslada a la oblea.
Zen 6c frente a Zen 5c
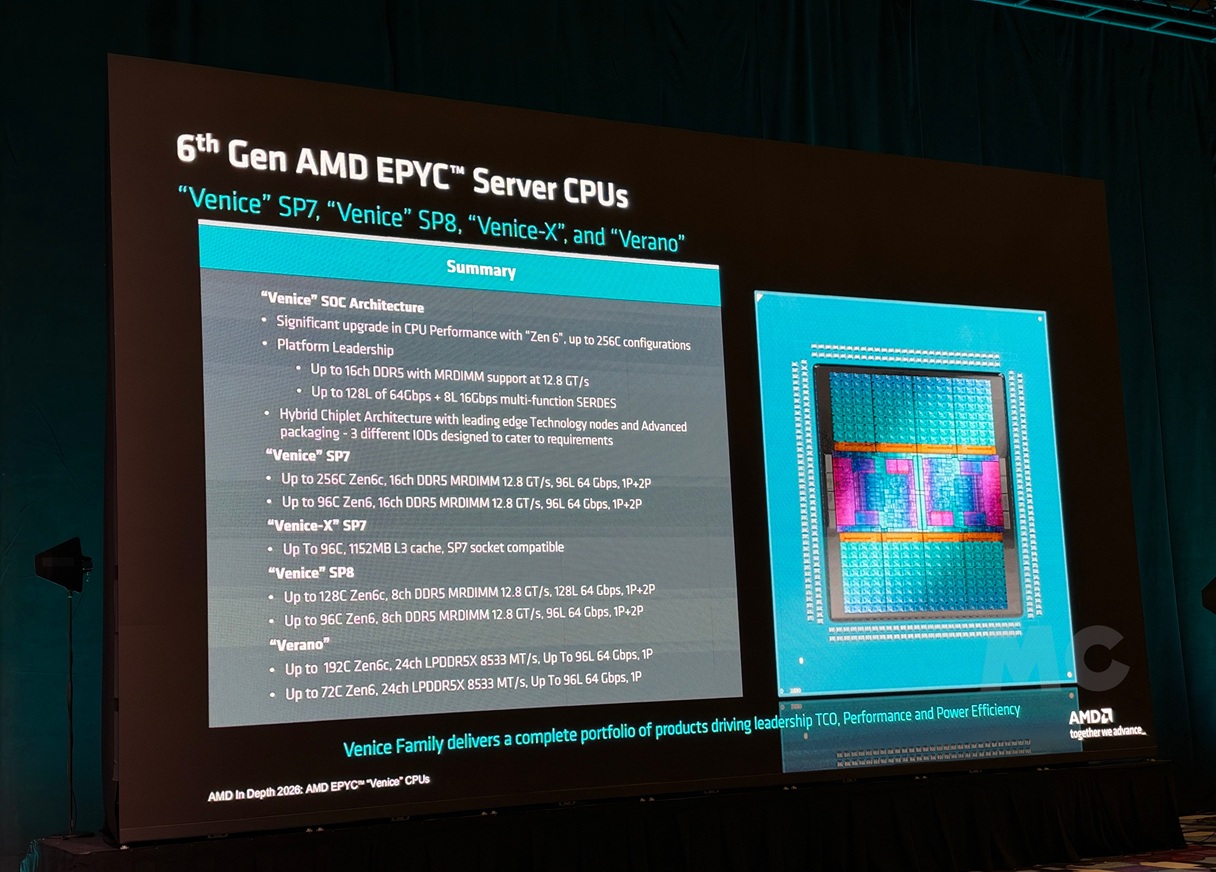
- Sube el máximo de núcleos por chiplet CPU de 16 a 32.
- La memoria caché por núcleo sube de 2 MB a 4 MB.
- La caché L3 máxima por chiplet CPU sube de 32 MB a 128 MB.
- La velocidad máxima sube de 3,7 GHz a 4,1 GHZ (en CPUs EPY).
- El máximo de núcleos por procesador aumenta de 192 a 256.
- El máximo de hilos por procesador aumenta de 384 a 512.
Esta arquitectura está optimizada para maximizar el rendimiento multihilo por socket.
La caché L3 apilada en 3D permitirá crear CPUs con hasta 1.152 MB de L3
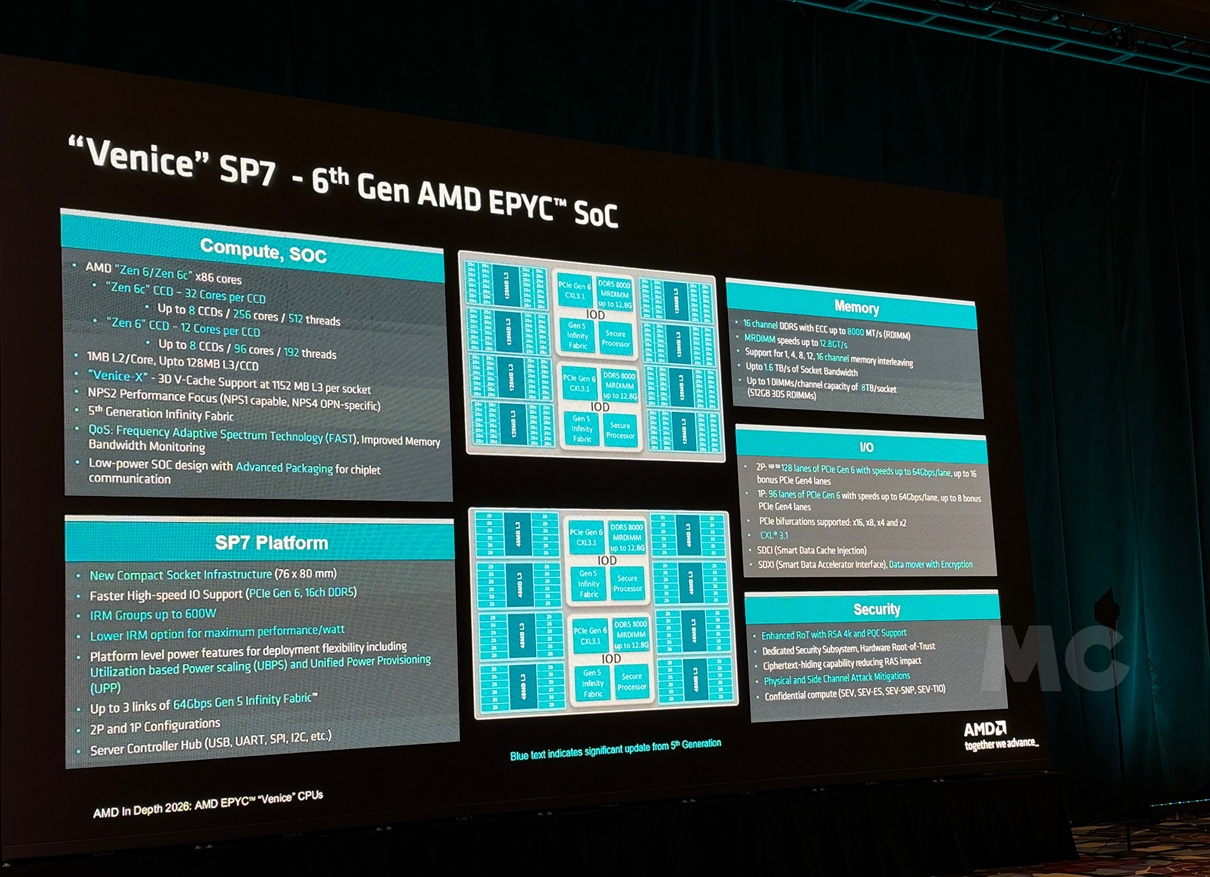
AMD ha confirmado que lanzará versiones de procesadores Zen 6 con caché L3 apilada en 3D. Dicha caché seguirá estando debajo del chiplet CPU, porque de esta manera dicho chiplet hace mejor contacto con el IHS y esto permite mejorar la disipación del calor.
Gracias al apilado de caché L3 en 3D, AMD será capaz de lanzar CPUs con hasta 1.152 MB de L3. Estos procesadores se identifican como Venice X, y tendrán hasta 96 núcleos y 192 hilos. Esto nos dice muchas cosas de lo que podemos esperar en el mercado de consumo general.
Un procesador AMD EPYC Venice X tendría 384 MB de L3 en total y 768 MB de caché L3 apilada en 3D. Esto quiere decir que cada chiplet de caché apilada en 3D dobla la caché L3 base, es decir, suma 96 MB de L3. Si trasladamos esto a los AMD Ryzen 10000X3D significa que cada chiplet CPU sumaría 96 MB de L3 adicionales por chiplet de caché apilado.
Por tanto, un hipotético Ryzen 7 10800X3D con 12 núcleos y 24 hilos tendría 48 MB de caché L3 + 96 MB de L3 apilada en 3D, lo que equivaldría a un total de 144 MB de L3 accesible por todos los núcleos del procesador. Esto debería mejorar notablemente el rendimiento en juegos.
Un breve vistazo al nuevo chiplet I/O
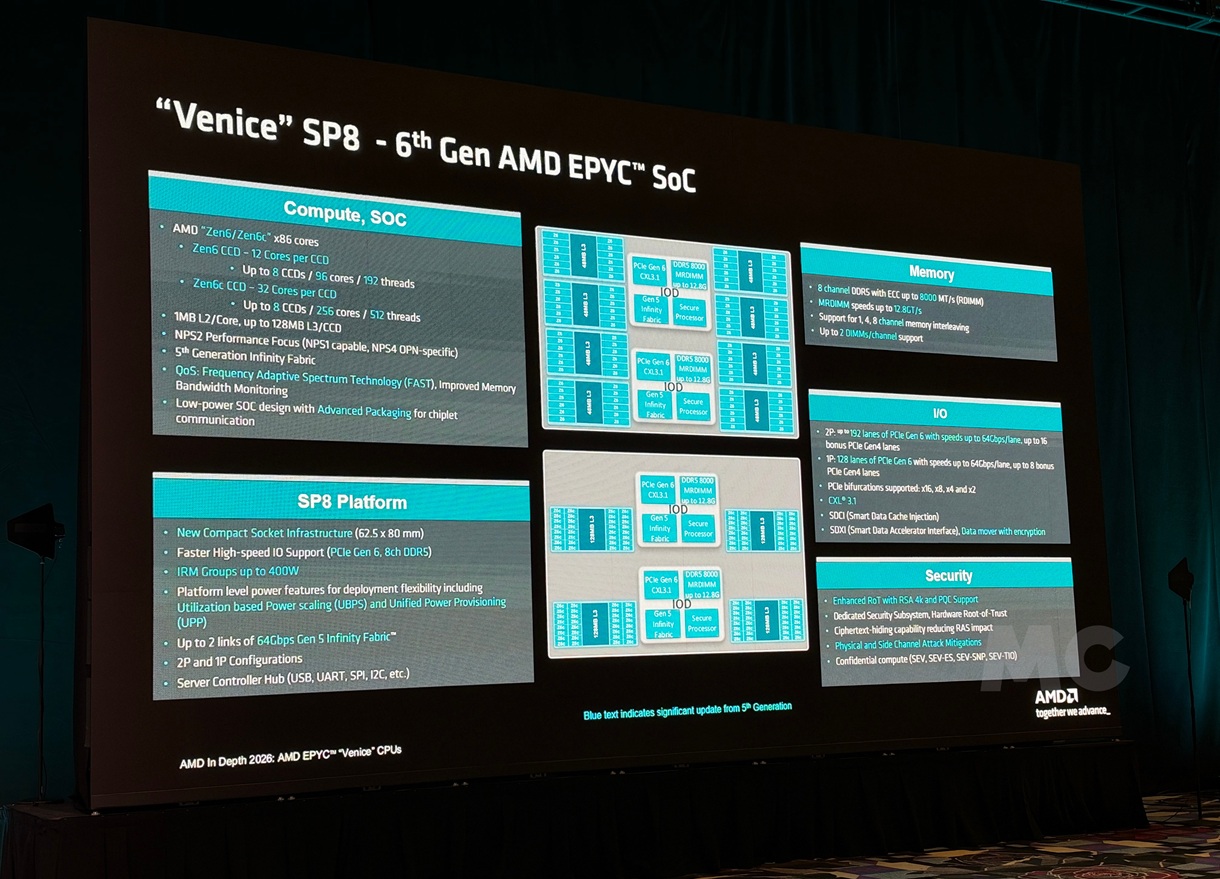
El chiplet SoC que mostró AMD durante la presentación es el que está presente en los procesadores EPYC. Este SoC no es el mismo que veremos en las versiones de Zen 6 y Zen 6c para consumo general, pero hay algunos detalles importantes que me llamaron mucho la atención y que deberían extenderse a los Ryzen de próxima generación:
- Mismo nodo de fabricación (6 nm de TSMC).
- Soporte de memoria DDR5 a mayor velocidad de forma nativa.
- Compatibilidad con el estándar PCIe Gen6.
La comunicación entre chiplets, tanto CPU (unidades CCD) como I/O, se llevará a cabo mediante el sistema de intercomunicación Infinity Fabric de quinta generación de AMD, que ofrece una mayor estabilidad, una menor latencia y permite una mayor frecuencia de trabajo.
Mejoras en FP y canales de datos frente a Zen 5 y Zen 5c
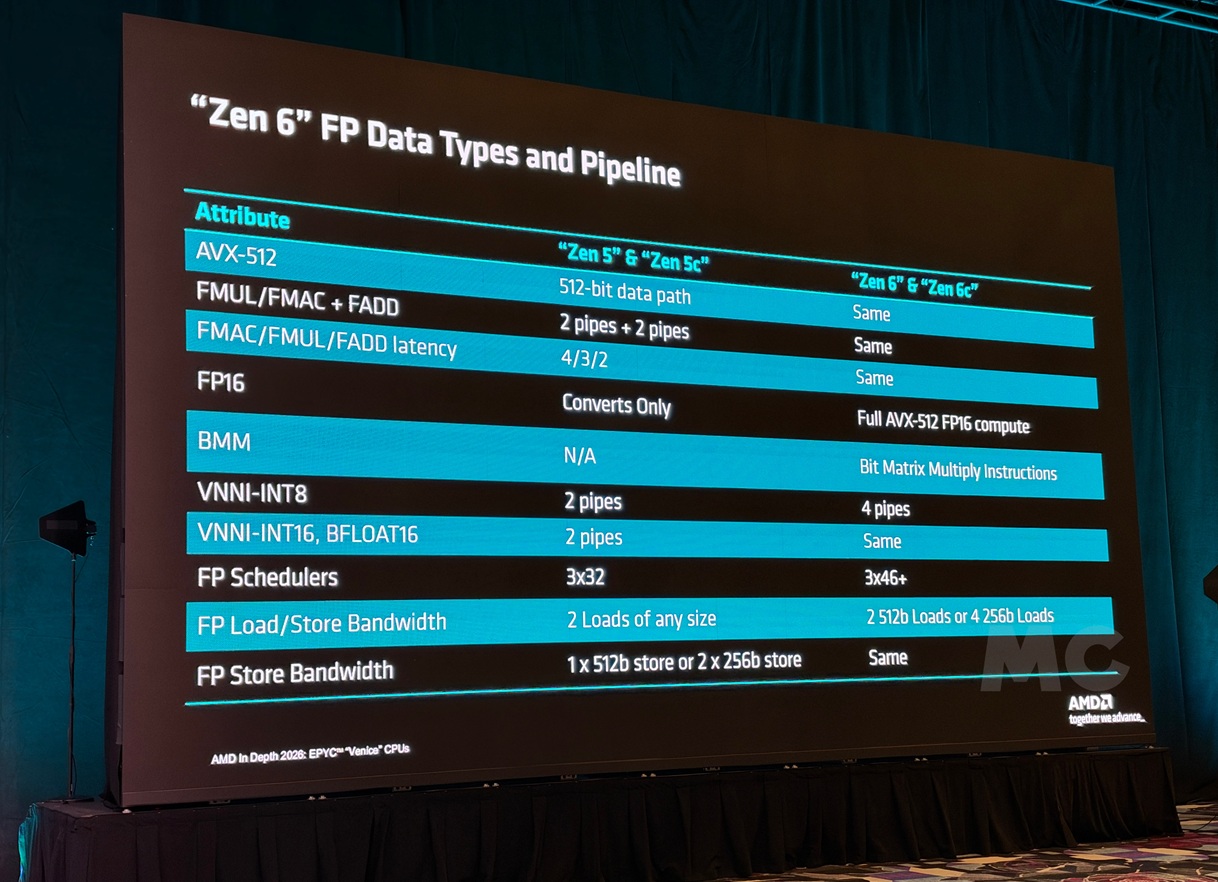
En la imagen adjunta podemos ver una comparativa sencilla pero directa que ilustra a la perfección los avances más importantes a nivel de FP (unidad de coma flotante) y de canales de datos que ha introducido AMD frente a la generación anterior.
Os dejo un resumen de esas mejoras introducidas en Zen 6 y Zen 6c para que podáis interpretar mejor la tabla:
- Soporte completo de FP16 vía AVX-512.
- Instrucciones de multiplicación de matrices de bits.
- Cuatro canales de datos VNNI-INT8 (dos más que en la generación anterior).
- Los programadores FP suben de 3×32 a 3×46+.
- El ancho de banda de la unidad FP en carga y almacenamiento suben de 2 cargas de cualquier tamaño a dos cargas de 512 bits o cuatro cargas de 256 bits.
Mejoras a nivel de IPC: hasta un 31% en Zen 6c
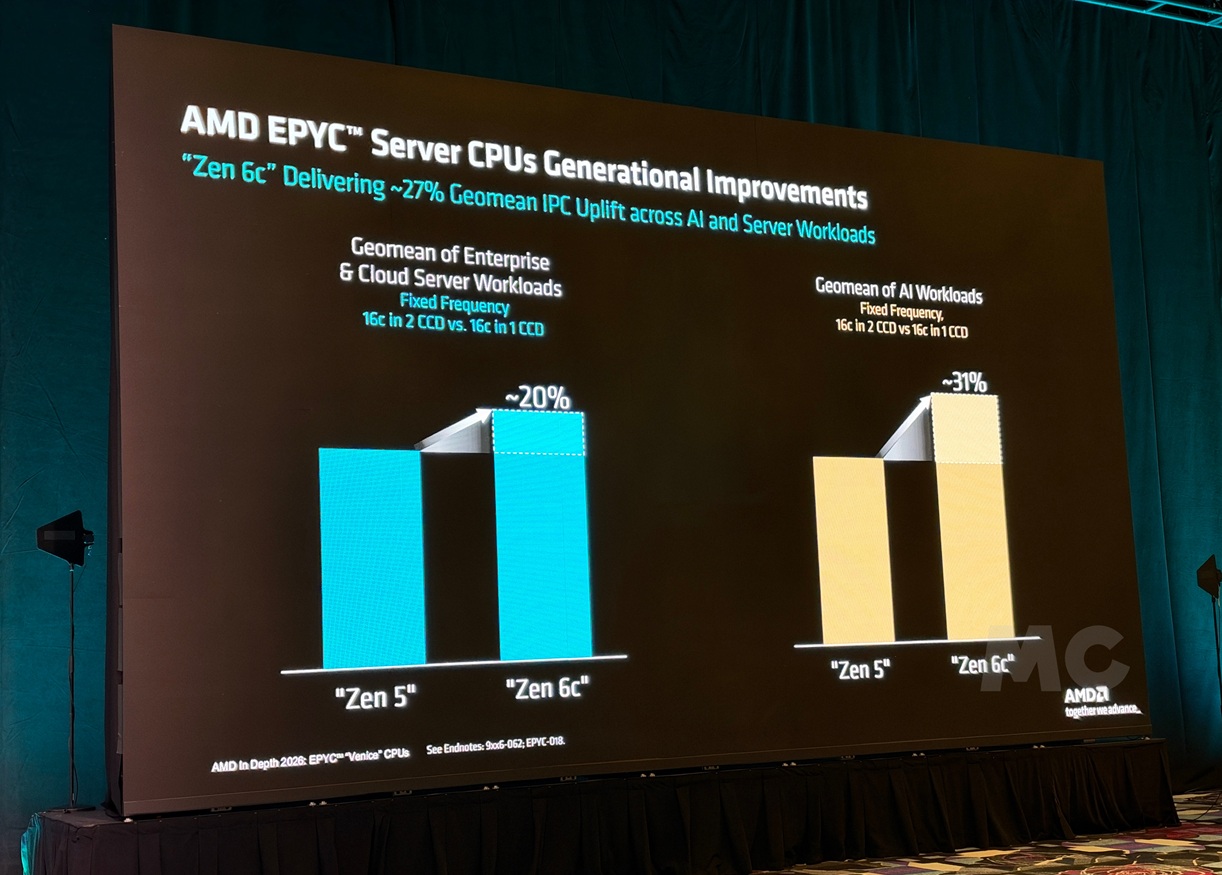
Según los datos oficiales que ha compartido AMD, un chiplet Zen 6c con 16 núcleos frente a dos chiplets de 8 núcleos Zen 5c (16 núcleos también) consigue, funcionando a la misma frecuencia, una mejora de rendimiento del 20% en cargas de trabajo para servidores y centros de datos en la nube, y un 31% más de rendimiento en cargas de IA.
Al tener el mismo número de núcleos y la misma velocidad de trabajo esos porcentajes de rendimiento reflejan la mejora de IPC de Zen 6c frente a Zen 5c en cargas concretas, pero debemos tener en cuenta que al estar configurado Zen 5c en dos chiplets tenemos una latencia mayor por la comunicación entre chiplets que no existe en Zen 6c, y por tanto la comparativa no es del todo equivalente.
Considerando ambos valores, la mejora del IPC en Zen 6c frente a Zen 5c sería de un 25,5% de media, teniendo en cuenta lo ya mencionado sobre la latencia en Zen 5c porque utiliza dos chiplets CPU. Es importante tener en cuenta que esto no quiere decir que la mejora del IPC en juegos vaya a ser también de un 25,5%.
Normalmente la mejora del IPC en juegos que consigue una nueva generación CPU suele ser inferior a los resultados de rendimiento mostrados en aplicaciones profesionales e IA. Ya lo vimos con Zen 5, que registraba una mejora media del 16% en dicho tipo aplicaciones, y que en juegos mostraba una mejora del IPC de alrededor de un 8% de media frente a Zen 4.
En este caso, creo que es bastante probable que la mejora del IPC de Zen 6 frente a Zen 5 sea de entre un 8% y un 15% en juegos, y que Zen 6c mejore el IPC en juegos frente a Zen 5c entre un 10% y un 18%. Hablamos de IPC, es decir, no incluimos la mejora de rendimiento que derivaría del aumento de frecuencias que traerán ambas arquitecturas.
Hablando de frecuencias, los aumentos que hemos visto en Zen 6 han sido modestos, solo 300 MHz, pero la subida de velocidad en Zen 6c sí que ha sido más marcada. Creo que veremos esa misma tendencia en los procesadores para consumo general basados en esas dos arquitecturas, estoy bastante convencido de que Zen 6 alcanzará o superará por poco los 6 GHz, y Zen 6c alcanzará o superará los 5 GHz. Incluyendo esos aumentos de velocidad de trabajo, la mejora de rendimiento monohilo podría ser de entre un 12% y un 20% en Zen 6 frente a Zen 5, y de entre un 15% y un 25% en Zen 6c frente a Zen 5c en juegos.








Zen 6 y Zen 6c de AMD a fondo: núcleos, configuración, rendimiento y comparativa frente a Zen 5 y Zen 5c

NZXT presenta las cajas H7 y H5 con cristal curvado y nuevas refrigeraciones de la serie Kraken

ASUS presenta la gráfica externa, XG Core Radeon

Convulsión en NVIDIA: amoríos, espionaje y consecuencias

10 portátiles en oferta de la campaña del Black Friday 2026

«Es la Siri que siempre hemos querido»: Apple cree que por fin ha arreglado su asistente

Rescuezilla, la ‘navaja suiza’ para clonación de sistemas

Cómo restablecer un móvil Android a la configuración de fábrica

Cómo limpiar a fondo un smartphone antes de venderlo o regalarlo

Windows 11 funciona con solo 128 MB de RAM, aunque a duras penas

Rockstar confirma el espacio necesario para GTA VI (212 GB) y adelanta su precarga

El jailbreak para Switch 2 avanza: juegan el remake de Ocarina of Time antes del lanzamiento
Zen 6 y Zen 6c de AMD a fondo: núcleos, configuración, rendimiento y comparativa frente a Zen 5 y Zen 5c

The Elder Scrolls VI: Sentinel ya es oficial y nos lleva a Hammerfell
Windows 11 funciona con solo 128 MB de RAM, aunque a duras penas
Rockstar confirma el espacio necesario para GTA VI (212 GB) y adelanta su precarga
Cómo restablecer un móvil Android a la configuración de fábrica

FRITZ!Box 7630 frente a FRITZ!Box 7690

-
 PrácticosHace 1 día
Rescuezilla, la ‘navaja suiza’ para clonación de sistemas
-
 PrácticosHace 6 días
Cómo restablecer un móvil Android a la configuración de fábrica
-
 PrácticosHace 3 días
Cómo limpiar a fondo un smartphone antes de venderlo o regalarlo
-
 NoticiasHace 6 días
Windows 11 funciona con solo 128 MB de RAM, aunque a duras penas